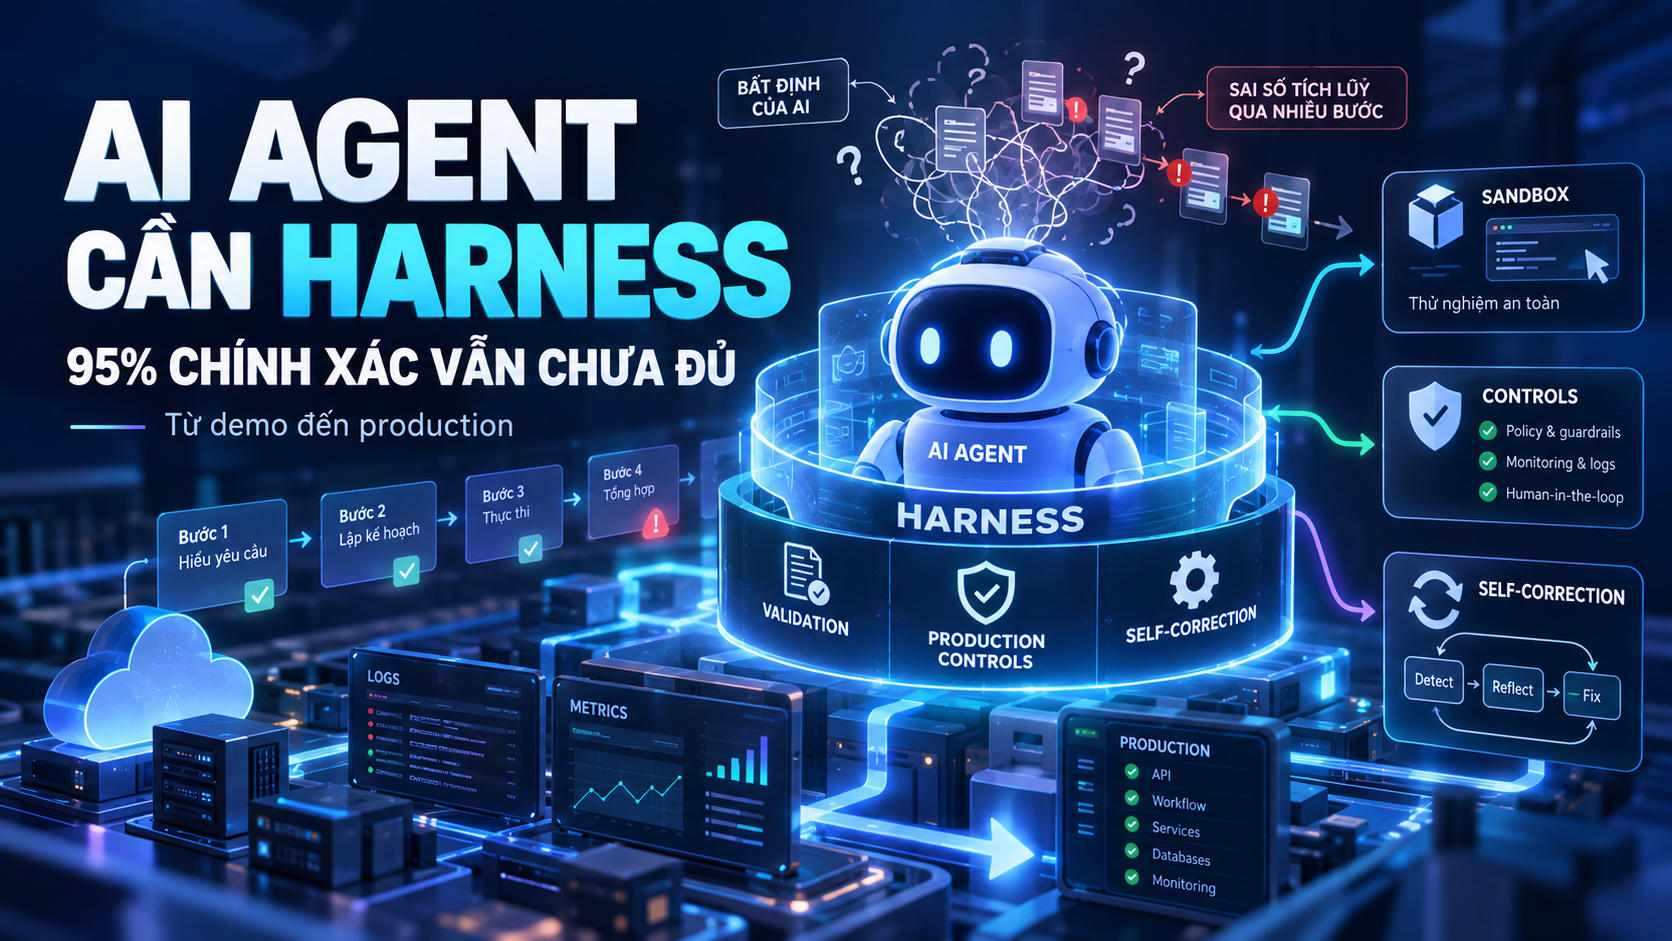
Phần 1 khép lại bằng một câu hỏi:
Khi Agent sai, hệ thống có đủ tốt để không sai theo nó không?
“Cần Harness” là một nhận thức.
“Lắp Harness” là một công việc.
Bài này là phần công việc, dựa trên “Harness Engineering (Phần 2): Cẩm nang hiện thực” của Atekco và “Harness engineering for coding agent users” của Birgitta Böckeler.
Công thức và nếm thử
Nấu ăn cần hai thứ.
Trước khi nấu: công thức.
Sau khi nấu: nếm thử.
Harness cũng vậy:
- Guides (Feedforward): dẫn đường để agent làm đúng ngay từ đầu.
- Sensors (Feedback): phát hiện khi agent vẫn làm sai.
Và có hai cách để kiểm tra.
Có thứ cân được: 15 gram muối.
Có thứ chỉ nếm được: món này có vừa miệng không.
- Computational: linter, type checker, test, policy. Nhanh, rẻ, lần nào cũng cho cùng kết quả.
- Inferential: LLM review, LLM-as-a-Judge. Hiểu ngữ nghĩa, nhưng chậm, tốn tiền, và có thể sai.
                 TRƯỚC (Guides)          SAU (Sensors)
              ┌──────────────────────┬──────────────────────┐
 Computational│ Quy tắc viết thành   │ Lint, typecheck,     │
   (cân)      │ code, policy         │ test, policy audit   │
              ├──────────────────────┼──────────────────────┤
 Inferential  │ Hướng dẫn ý đồ,      │ LLM review,          │
   (nếm)      │ Skill kiến trúc      │ LLM-as-a-Judge       │
              └──────────────────────┴──────────────────────┘
Nguyên tắc vận hành:
Cân được thì đừng nếm.
Guides: lời dặn không kiểm tra được chỉ là lời khuyên
Nội quy chung cư “giữ trật tự chung” nghe rất hay, nhưng không ai biết thế nào là vi phạm.
Nội quy “không khoan tường sau 22h” nghe khô khan, nhưng bảo vệ đi một vòng là biết.
Agent cũng vậy.
“Hãy viết code sạch” gần như vô tác dụng.
“Không dùng kiểu any“, kèm một rule lint chặn nó, thì có.
Một Guide tốt cần cụ thể và kiểm tra được bằng máy. Các dạng phổ biến:
- File hướng dẫn ở gốc dự án:
AGENTS.md,CLAUDE.md,.cursorrules… Nội quy chung của cả dự án. - Quy ước theo domain: backend một bộ luật, frontend một bộ luật.
- Policy viết thành code: ví dụ Rego với Open Policy Agent. Chạy vài mili giây, không tốn token.
- Playbook có cổng kiểm soát: typecheck chưa sạch thì pipeline dừng. Giống dây chuyền ô tô, khung xe chưa đạt thì không lắp động cơ.
Sensors: báo “sai” thì chưa đủ
Một bài kiểm tra chỉ có chữ “Sai” màu đỏ không dạy được gì.
Một bài ghi “Sai ở bước 3, xem lại công thức trang 42” thì có.
Sensor tốt phải trả về chỉ dẫn sửa cụ thể:
TYPECHECK_FAIL  3 errors
  src/orders/service.ts:42 — implicit any
  FIX: xem mục "Type Safety" trong AGENTS.md
Böckeler gọi đây là constructive prompt injection:
thông báo lỗi chính là prompt tiếp theo của agent.
Tầng computational rẻ đến mức không có lý do để bỏ qua.
Atekco chạy 12 policy OPA trên một codebase thực tế, tìm ra 84 vi phạm, với 0 lần gọi LLM.
Tầng inferential chỉ dùng cho những gì không cân được, như mâu thuẫn giữa các tài liệu thiết kế. Cách Atekco tổ chức giống một hội đồng bảo vệ luận văn:
R0  Kiểm tra hồ sơ          → thiếu tài liệu gốc thì dừng
R1  Chấm từng tài liệu
R2  Đối chiếu chéo  ║  Tính lại số liệu bằng Bash
R3  Tổng hợp, ra phán quyết
Chi tiết đáng chú ý: ngay trong tầng inferential, phần tính toán vẫn giao cho Bash, không tin con số LLM đưa ra.
Nhưng sensor inferential cũng là LLM.
AI viết, AI review, AI merge thì chẳng khác gì tự chấm bài của chính mình.
Khi điểm thấp hoặc các “giám khảo” bất đồng, con người phải bước vào.
Ba mục tiêu kiểm soát, khó dần
1. Bảo trì: dọn nhà định kỳ.
Quét hàm quá dài, code trùng lặp, code chết, truy vấn N+1. Hoàn toàn computational. Agent viết code nhanh thì cũng tạo rác nhanh.
2. Kiến trúc: giữ đúng quy hoạch.
Fitness Functions (Neal Ford) liên tục kiểm tra xem kiến trúc còn giữ được đặc tính mong muốn không. Giống thanh tra xây dựng: kiểm tra ở mọi giai đoạn, không đợi nhà xây xong.
3. Hành vi: phần khó nhất.
Böckeler gọi đây là “the elephant in the room”. Atekco không giải bằng AI mà bằng hạ tầng:
- Optimistic locking: hai người cùng đặt ghế G7 trong rạp phim, ai thanh toán trước thì được, người còn lại chọn lại.
- Atomic claim: lấy số thứ tự ở ngân hàng, mỗi người một số, không trùng.
- Audit log bất biến: sổ kế toán viết bút mực, sai thì ghi bút toán điều chỉnh, không tẩy xóa.
- Scenario test cố định: hơn 100 kịch bản nghiệp vụ, agent sửa gì thì chúng vẫn phải chạy đúng.
Và một cảnh báo: đừng tin quá vào test do chính AI sinh ra. Agent hiểu sai nghiệp vụ sẽ viết code sai, rồi viết test để chứng minh code sai đó là đúng.
Khi quy tắc vượt quá khả năng viết thành code, Harness chỉ còn một việc: dừng lại và gọi con người.
Keep Quality Left: bịt ổ điện thay vì nhắc mãi
Sửa móng khi đang đổ móng thì rẻ.
Sửa móng khi nhà đã lên năm tầng thì có khi phải đập đi.
Với agent còn tệ hơn, vì nó không dừng lại ở lỗi nền tảng mà xây tiếp lên trên, nhanh và rất tự tin.
 Pre-commit          CI/CD                 Liên tục
 Lint, LSP     ───▶  Mutation test   ───▶  Quét code chết,
 (mili giây)         Review kiến trúc      SLO, error rate
Nhưng điều quan trọng nhất là một nguyên tắc:
Mỗi khi agent vi phạm ở sensor phía sau, hãy đẩy quy tắc đó sang bên trái.
Trẻ con chạm ổ điện lần thứ ba thì không ai nhắc nữa. Người ta bịt ổ điện lại.
Agent lặp lại cùng một lỗi typecheck? Thêm rule lint.
Agent vi phạm pattern kiến trúc? Viết nó thành policy.
Mỗi lỗi không chỉ được sửa, mà còn trở thành một lớp bảo vệ mới.
Bắt đầu từ đâu?
Ba câu hỏi:
- Vấn đề thuộc mục tiêu nào? Bảo trì, kiến trúc hay hành vi.
- Can thiệp lúc nào? Trước khi làm (Guides) hay sau khi làm (Sensors).
- Cần độ chính xác thế nào? Tuyệt đối thì computational, cần hiểu ngữ nghĩa thì inferential.
Thứ tự triển khai:
Computational + Guides → Computational + Sensors → Inferential → Con người
Nhiều team làm ngược lại, bắt đầu bằng “để AI review code cho AI” vì nghe hiện đại.
Trong khi một rule lint 5 dòng thường bắt được nhiều lỗi hơn, rẻ hơn, và không bao giờ đổi ý.
Vài điểm cần cẩn thận khi áp dụng
1. Atomic claim phải claim đúng một task.
Ví dụ trong bài Atekco có dạng UPDATE tasks SET status='claimed' ... WHERE status='pending'. Câu lệnh atomic, nhưng không giới hạn số dòng, nên một agent sẽ nhận tất cả task đang chờ. Máy lấy số không đưa cả xấp số cho người đầu tiên. Với PostgreSQL:
UPDATE tasks SET status = 'claimed', claimed_by = $1
WHERE id = (
  SELECT id FROM tasks WHERE status = 'pending'
  ORDER BY created_at LIMIT 1
  FOR UPDATE SKIP LOCKED
)
RETURNING *;
2. Sensor thô dạy agent cách phớt lờ sensor.
Kiểm tra “cấm any” bằng rg "any" sẽ bắt luôn company, many. Chuông báo cháy kêu mỗi lần nấu cơm thì sớm muộn cả nhà sẽ không để ý nữa, kể cả khi cháy thật. Dùng công cụ đúng, như rule @typescript-eslint/no-explicit-any.
3. Mỗi lớp review là một lớp chi phí.
Trước khi thêm một lớp LLM review, cần trả lời: lớp này bắt được lỗi gì mà lớp computational phía trước không bắt được?
Kết luận
Model tạo ra năng lực. Harness tạo ra độ tin cậy.
Và độ tin cậy đó được lắp từ:
- Guides để agent biết đường đi.
- Sensors để biết khi nào agent đi sai, và chỉ đường quay lại.
- Computational ở mọi chỗ có thể.
- Inferential ở chỗ chỉ ngữ nghĩa mới đo được.
- Con người ở chỗ sai một lần là quá đắt.
Đừng nhắc agent mãi về cùng một lỗi. Hãy xây hệ thống để lỗi đó không thể lặp lại.
84 Lỗi, 0 Lần Gọi LLM: Lắp Harness Cho AI Agent Nên Bắt Đầu Từ Đâu?
Phần 1 khép lại bằng một câu hỏi: Khi Agent sai, hệ thống có đủ