Bài trước khép lại bằng một câu:
Microsoft có thể cho thuê bếp. Nhưng không ai nếm món thay cho đầu bếp.
Ba tuần sau, tại Ignite 2026, Microsoft không đề nghị nếm thay.
Họ đề nghị một thứ khác: giữ sổ phàn nàn, gom lỗi, và thử công thức mới giúp đầu bếp.
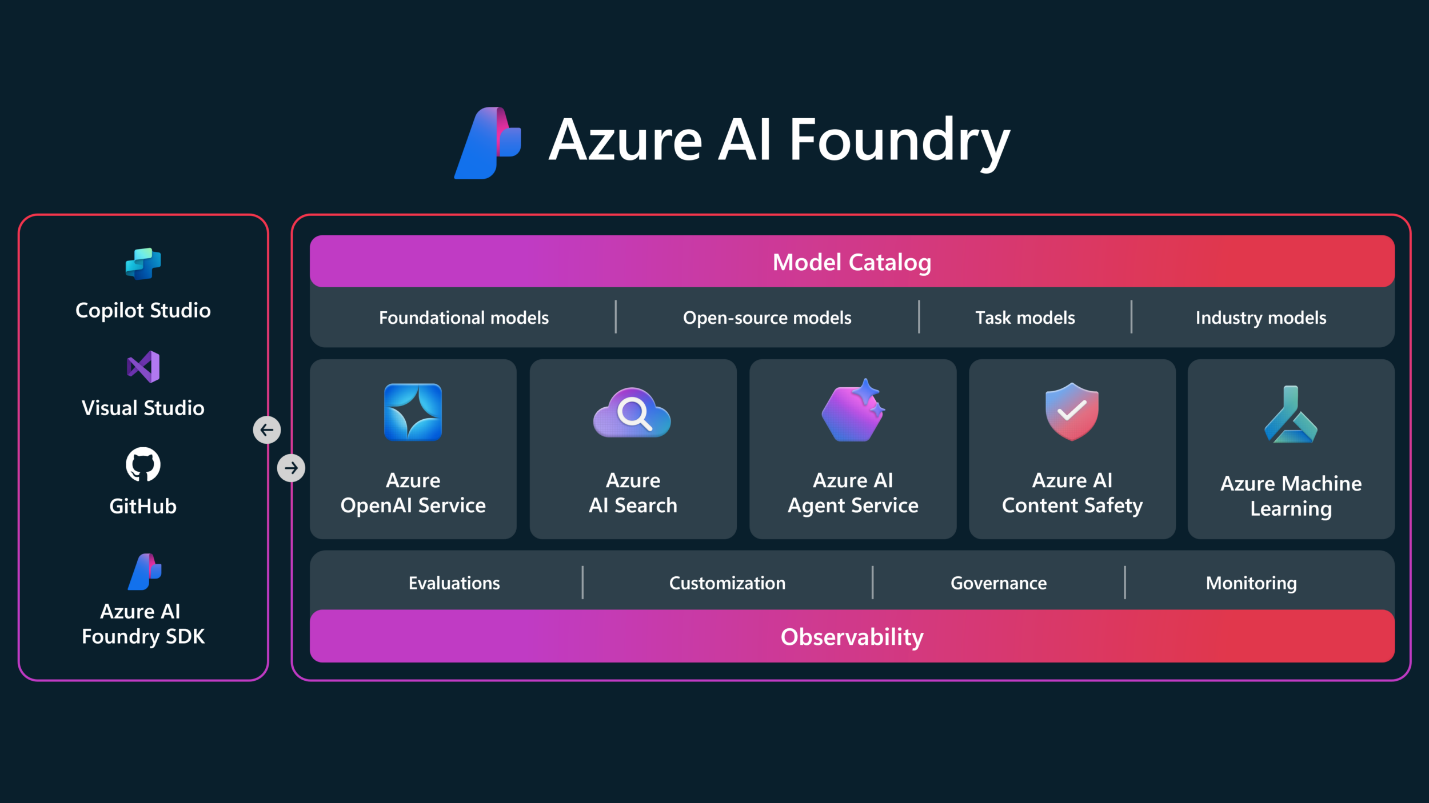
Tên gọi chính thức là: continuous improvement, vòng cải tiến liên tục cho agent trong Microsoft Foundry.
Câu hỏi đặt ra:
Bắt được lỗi là một nửa. Nửa còn lại, ai sửa và ai chịu trách nhiệm cho bản sửa?
(Thông tin trong bài tính đến ngày 19/11/2026. Nhiều tính năng vẫn đang preview.)
Quán ăn và cuốn sổ phàn nàn
Một quán phở mở được ba tháng.
Mỗi ngày vài khách phàn nàn.
“Nước dùng hơi mặn.”
“Chờ lâu quá.”
“Bánh phở bị nát.”
Nếu chủ quán chỉ nghe rồi quên, tháng sau vẫn những lời phàn nàn đó.
Một chủ quán giỏi làm khác:
- Ghi hết vào sổ.
- Cuối tuần đếm xem lỗi nào lặp lại nhiều nhất.
- Thử nấu lại nồi nước dùng với ít muối hơn.
- Mời vài khách quen nếm thử trước khi đổi cả thực đơn.
- Đổi xong, tiếp tục ghi sổ.
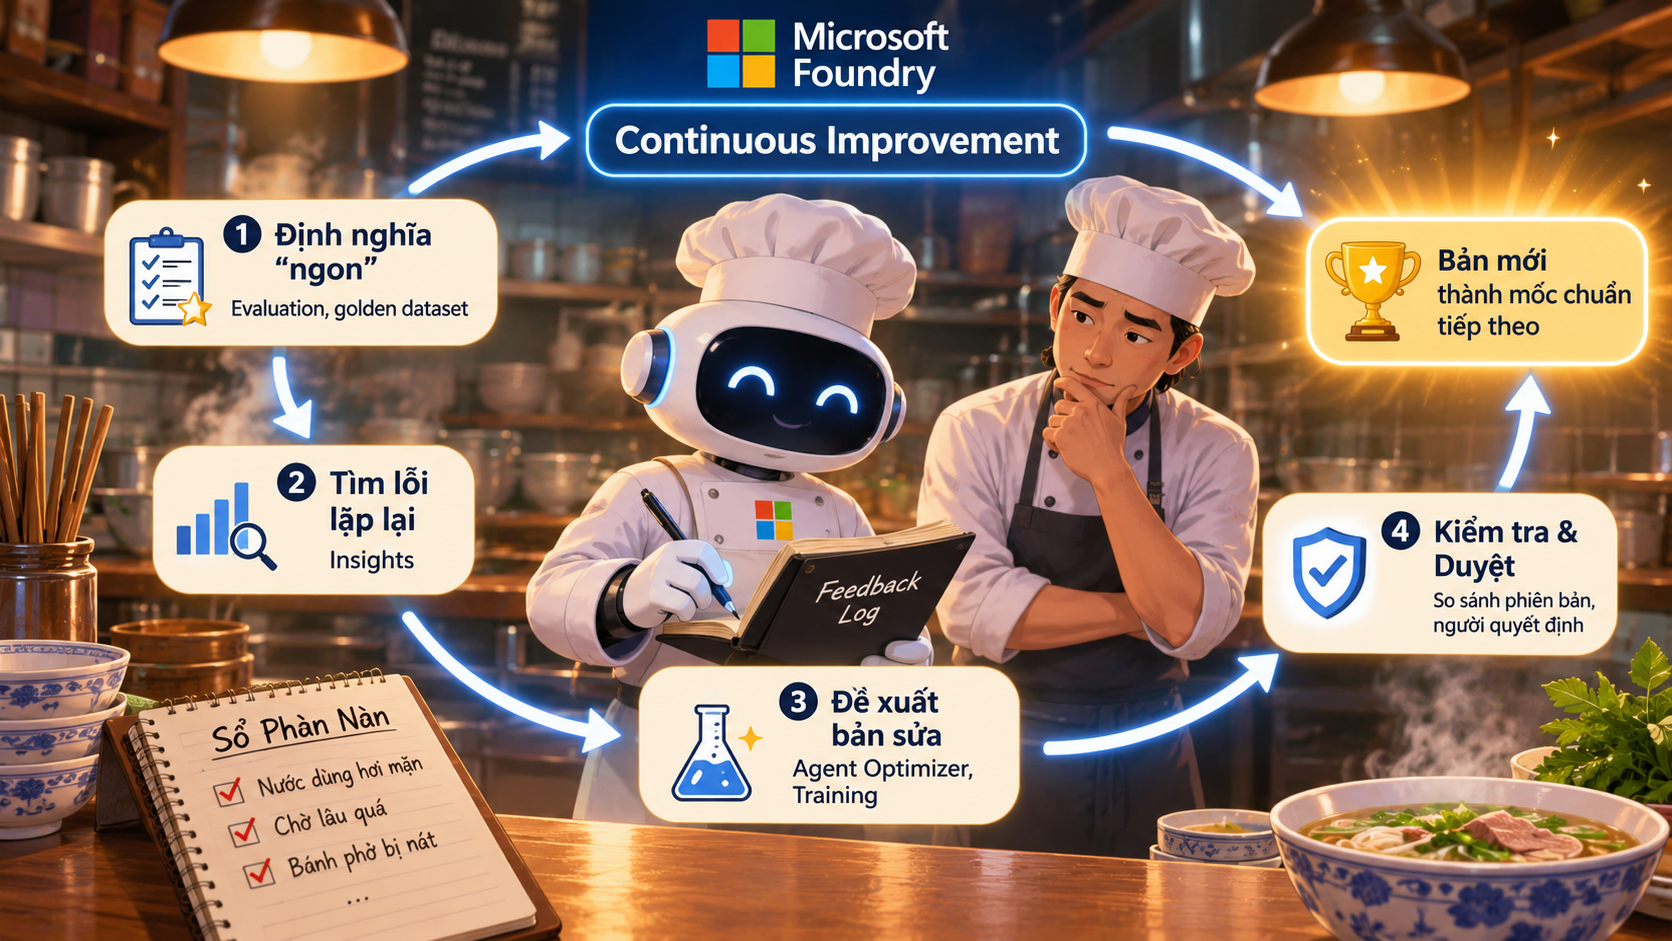
Đó chính là vòng lặp Microsoft vừa đóng gói vào Foundry:
        ┌──────────────────────────────────────────┐
        │                                          │
        ▼                                          │
  1. ĐỊNH NGHĨA "NGON"     Evaluation, golden dataset
        │                  (công thức chuẩn, khẩu vị chuẩn)
        ▼
  2. TÌM LỖI LẶP LẠI       Insights
        │                  (đếm sổ phàn nàn)
        ▼
  3. ĐỀ XUẤT BẢN SỬA       Agent Optimizer, Training
        │                  (thử nồi nước dùng mới)
        ▼
  4. KIỂM TRA & DUYỆT      So sánh phiên bản, người quyết định
        │                  (khách quen nếm trước)
        ▼
  Bản mới thành mốc chuẩn tiếp theo ─────────────┘
Microsoft tóm lại bằng một câu: “Mỗi cải tiến được triển khai trở thành mốc chuẩn tiếp theo.”
Bước 1: Trước khi sửa, phải định nghĩa thế nào là “ngon”
Không ai sửa được món ăn nếu không biết món ăn đúng vị trông thế nào.
Foundry cho ba công cụ:
- Rubric evaluator: bộ tiêu chí chấm điểm theo luật của doanh nghiệp.
- Annotation trên trace (preview): chuyên gia đọc lại các cuộc hội thoại thật, đánh dấu chỗ agent làm tốt, chỗ làm dở, và lẽ ra phải làm gì.
- Golden dataset (preview): bộ câu hỏi kèm đáp án chuẩn, dùng làm thước đo cố định.
Annotation là phần đáng giá nhất.
Một agent hỗ trợ khách hàng ngân hàng trả lời “Thẻ của quý khách sẽ được mở khóa trong 24 giờ.”
Nghe trôi chảy.
Nhưng chỉ nhân viên nghiệp vụ mới biết: thẻ bị khóa do nghi gian lận thì không được hứa mở trong 24 giờ.
Máy không tự biết điều đó.
Phải có người nói cho nó biết.
Foundry biến những ghi chú đó thành test case, rồi thành bộ đánh giá dùng lại được cho mọi phiên bản sau.
Bước 2: Insights, đếm sổ thay vì đọc từng tờ
Một agent chạy thật mỗi ngày sinh ra hàng nghìn trace.
Không ai đọc hết được.
Insights (GA) làm việc của người đếm sổ: gom các lỗi lặp lại thành nhóm, xếp hạng, đưa ra bằng chứng và gợi ý nguyên nhân có thể.
Ví dụ những nhóm lỗi Microsoft nêu: bịa thông tin, số token tăng vọt bất thường.
Điểm đáng chú ý: Insights đọc được trace của cả agent viết bằng LangGraph, LangChain, CrewAI, không chỉ agent của Microsoft.
Giống thuê một kế toán biết đọc sổ sách của mọi quán, không chỉ quán theo mẫu của mình.
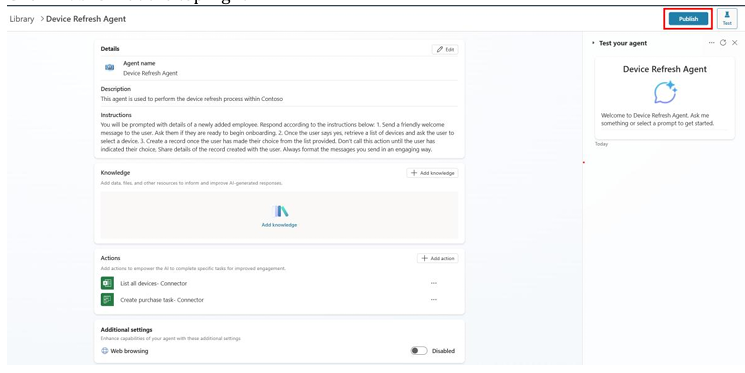
Bước 3: Agent Optimizer, thử công thức mới trong bếp phụ
Biết lỗi rồi thì sửa thế nào?
Agent Optimizer đề xuất các bản sửa cho ba thứ:
- Instructions: lời dặn cho agent.
- Skills: các gói hướng dẫn, script dùng lại được.
- Lựa chọn model.
Mỗi bản đề xuất được chạy thử với bộ evaluation của team.
Kết quả bày ra theo ba trục: chất lượng, tốc độ, chi phí.
Có thêm ba nhánh đi kèm, đều đang preview:
- Gửi thẳng lỗi từ Insights sang Optimizer: từ “lỗi này lặp lại 300 lần” sang “đây là ba bản sửa, bản nào qua được bài kiểm tra”.
- Skill optimization: học từ các lần làm việc cũ và phản hồi của chuyên gia để tạo skill mới hoặc cải thiện skill cũ. Skill có phiên bản, quay lui được.
- Cost optimization: tìm cấu hình rẻ hơn, chẳng hạn model nhỏ hơn, mà chất lượng không giảm.
Giống bếp phụ phía sau quán.
Đầu bếp thử năm nồi nước dùng khác nhau ở đó.
Khách ngoài sảnh vẫn ăn nồi cũ cho tới khi có quyết định.
Microsoft viết rất rõ: “Không có gì thay đổi ở production cho tới khi team áp dụng nó.”
Khi đổi công thức không đủ: đào tạo lại đầu bếp
Có những lỗi không sửa được bằng lời dặn.
Một đầu bếp chưa từng nấu món Huế thì đưa công thức chi tiết đến đâu, bát bún bò vẫn thiếu cái hồn.
Lúc đó phải cho đi học.
Foundry có hai lối:
- Managed Training: đưa dữ liệu của doanh nghiệp vào, Foundry lo phần huấn luyện lại model.
- Programmed Training (preview): kỹ sư tự viết công thức huấn luyện bằng Python, Foundry chạy trên GPU serverless.
Một con số được Microsoft dẫn: Alaska Airlines thử tinh chỉnh model để phân loại báo cáo bảo dưỡng máy bay.
Độ chính xác tăng từ 81,2% lên 91,1%, và nhân viên có chuyên môn vẫn giữ quyền duyệt cuối.
Chi tiết cuối mới là điều đáng chú ý nhất.
Máy giỏi hơn, nhưng con người vẫn ký.
Bước 4: Nếm trước, đổi sau
Bản sửa tốt trong bếp phụ chưa chắc tốt ngoài sảnh.
Foundry cho kiểm tra trước khi phát hành:
- So sánh các phiên bản bằng kiểm định thống kê, không phải bằng cảm giác.
- Gắn bước kiểm tra vào GitHub Actions hoặc Azure DevOps. Bản nào không qua ngưỡng chất lượng thì pipeline chặn lại.
- Sau khi phát hành: lấy mẫu traffic thật để đánh giá liên tục, chạy lại golden dataset theo lịch, quét red-team định kỳ.
Đây chính là ý Sensors của bài Harness phần 2, chỉ là giờ đặt ở cuối dây chuyền thay vì ở đầu.
Cải tiến chưa được đo lại thì chỉ là thay đổi.
Vài điểm cần cẩn thận
1. Bộ evaluation là trần chất lượng.
Optimizer chỉ tối ưu theo đúng thứ được đo.
Bộ test thiếu trường hợp nào, bản sửa có thể hỏng đúng trường hợp đó mà vẫn “đạt”.
Giống học sinh học tủ.
Điểm thi cao, nhưng gặp đề lạ là lúng túng.
Khi thước đo trở thành mục tiêu, nó không còn là thước đo tốt nữa.
Thời gian đầu tư vào golden dataset quyết định chất lượng của cả vòng lặp, chứ không phải độ thông minh của Optimizer.
2. AI chấm bài cho AI.
Microsoft-Decision-1.1 có thể làm “giám khảo” trong Foundry Evaluations.
Nhanh và rẻ.
Nhưng giám khảo cũng là model, cũng có điểm mù.
Giống hai học sinh chấm chéo bài cho nhau.
Tiện, nhưng thỉnh thoảng thầy giáo vẫn phải chấm lại một xấp để kiểm tra.
3. “Con người quyết định” có thể chỉ là nút bấm.
Optimizer xếp hạng sẵn, gợi ý sẵn bản tốt nhất.
Sau tuần thứ mười, rất dễ bấm “Áp dụng” mà không đọc.
Giống ký duyệt hồ sơ lúc cuối ngày: chữ ký có, nhưng không ai thật sự xem.
Cần ghi rõ ai có quyền duyệt bản sửa, và họ phải xem gì trước khi duyệt.
4. Thời gian của chuyên gia là nút thắt thật.
Annotation cần người hiểu nghiệp vụ: bác sĩ, luật sư, kế toán trưởng.
Đó là những người bận nhất trong tổ chức.
Không có họ, vòng lặp vẫn quay, nhưng quay quanh một định nghĩa “ngon” do kỹ sư tự đoán.
5. Rẻ hơn chưa chắc an toàn bằng.
Cost optimization đổi sang model nhỏ hơn mà điểm vẫn giữ.
Nhưng điểm giữ trên bộ test, không phải trên mọi tình huống hiếm gặp ngoài đời.
Đổi sang nhà cung cấp nguyên liệu rẻ hơn, món chính vẫn ngon.
Món đặc biệt chỉ nấu mỗi tháng một lần thì chưa ai thử.
6. Trạng thái tính năng chưa thống nhất.
Insights và Agent Optimizer được ghi là GA.
Annotation, golden dataset, skill optimization, cost optimization, nhánh gửi lỗi sang Optimizer thì vẫn preview.
Các nguồn bên ngoài còn ghi lệch nhau về trạng thái.
Trước khi đưa vào kế hoạch, nên kiểm tra lại trên Microsoft Learn.
7. Tài sản thật là dữ liệu đánh giá.
Trace, annotation, golden dataset là kết tinh hiểu biết nghiệp vụ của tổ chức.
Chúng đáng giá hơn bất kỳ phiên bản agent nào.
Trước khi dồn hết vào một nền tảng, nên kiểm tra khả năng xuất chúng ra ngoài.
Sổ công thức của quán phải nằm trong tay chủ quán, không phải trong ngăn kéo của bếp thuê.
Kết luận
Hai bài trước nói về lắp Harness và thuê Harness.
Bài này nói về chuyện xảy ra sau khi agent đã chạy thật.
Microsoft đã tự động hóa được phần nặng nhọc:
đọc hàng nghìn trace, gom lỗi, viết bản sửa, chạy thử.
Nhưng có ba thứ vòng lặp không tự sinh ra:
- Định nghĩa thế nào là đúng.
- Người hiểu nghiệp vụ để chỉ ra chỗ sai.
- Người chịu trách nhiệm ký cho bản sửa.
Vòng lặp chỉ tốt bằng ba thứ đó.
Máy có thể đề xuất bản sửa. Nhưng định nghĩa “đúng” vẫn phải do con người viết ra.